




모델 경량화·라우팅으로 처리 효율 최대 4배 개선
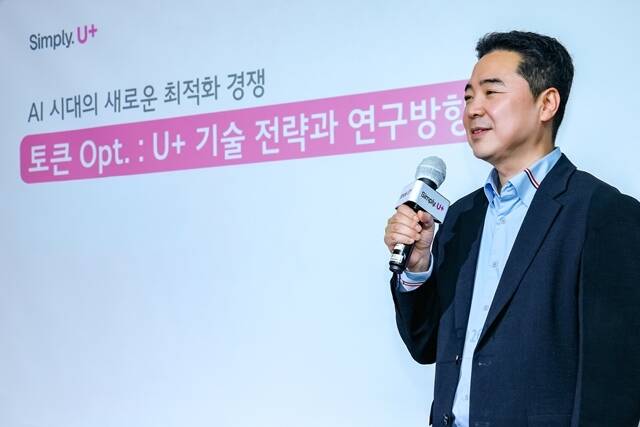
[더팩트ㅣ이윤경 기자] LG유플러스가 실제 서비스 운영 과정에서 검증한 인공지능(AI) 토큰 최적화 기술을 앞세워 내년 기업 고객(B2B) 시장 공략에 나선다. 모델 경량화와 작업별 모델 라우팅 등을 통해 AI 서비스 품질을 유지하면서 토큰 사용 비용을 낮추고, 기업의 AI 운영 부담을 줄이겠다는 전략이다.
15일 업계에 따르면 LG유플러스는 지난 12일 기자들 대상으로 'AI 토큰 최적화 스터디'를 열고 실제 상용 환경에서 검증한 비용 절감 기술과 연구 성과, 향후 사업 계획을 공개했다. 내년부터 협력사와의 제휴형 사업과 자체 인프라 구축을 병행할 방침이다.
◆ '실전 레시피'로 모델 성능 경쟁 대신 운영 효율 승부…AI 업무당 총비용 절감
LG유플러스가 토큰 사업의 경쟁력으로 내세우는 것은 실제 서비스 운영 과정에서 축적한 'AI 모델 운영 레시피'다. 대규모 트래픽과 고객 이용 패턴을 분석해 작업 난도와 특성에 맞는 모델을 선택하고, 불필요한 연산을 줄여 전체 비용을 낮추는 방식이다.
대표적인 사례는 AI 통화 서비스 '익시오'와 AI 컨택센터(AICC)다. 익시오 출시 초기에는 LG AI연구원과 개발한 온디바이스 모델을 기본으로 활용하고, 고난도 추론에는 구글의 제미나이를 적용했다. 이후 실제 서비스에서 쌓은 경험을 바탕으로 자체 AI 모델과 엑사원(EXAONE) 등을 조합해 품질과 비용 효율을 높였다.
자체 모델이 처리하는 트래픽 비중은 늘어나는 추세다. 다만 고객 요구가 복잡해지면서 고난도 추론이 필요한 작업에는 외부 모델을 병행하는 하이브리드 방식을 유지하고 있다. 사내 인공지능 전환(AX)에도 최적화 기술을 적용하고 있다. 토큰당 단가를 낮추는 데 그치지 않고 AI가 하나의 업무를 완수하는 데 드는 총비용(Task Cost)을 줄이는 것이 목표다.
이혜진 LG유플러스 기술 전략 담당은 "토큰 최적화를 통해 고객이 체감할 수 있는 부분은 파격적인 가격일 것"이라며 "B2C 고객에게는 지금까지 누릴 수 없었던 초고성능 AI를 커피 한 잔 값으로 이용할 수 있도록 하는 것"이라고 말했다. 이어 "B2B 고객 관점에서는 AI가 돈 먹는 하마가 아니라 진짜 일하는 직원이 되도록 하는 것이 중요하다"며 "기업들이 AI를 실전에 투입할 수 있는 열쇠가 토큰 최적화에 있다"고 강조했다.
LG유플러스는 통신사로서 회선부터 인프라, 모델 운영까지 AI 서비스 전반을 최적화할 수 있다는 점도 강점으로 꼽는다. 고객이 수행하려는 업무를 파악해 모델 선택과 에이전트 실행 과정까지 조정함으로써 불필요한 연산과 비용을 줄일 수 있다는 설명이다.
다만 이상엽 LG유플러스 최고기술책임자(CTO·전무)는 토큰 최적화가 빅테크와 모델 성능을 겨루는 경쟁과는 다르다고 강조했다. 그는 "결국 모델 간 경쟁이 아니라 고객이 필요한 작업을 얼마나 저렴한 비용으로 처리하도록 엔지니어링하느냐의 문제"라고 말했다.
◆ 코딩 비용 90% 절감·처리 효율 4배…AI 인프라 최적화
LG유플러스는 자체 기술 검증에서 코딩 영역의 AI 운영 비용을 기존에 사용하던 모델 대비 90% 이상 절감한 사례를 확인했다. 동일한 인프라에서 연산 처리 방식을 개선해 처리 효율을 최대 4배 높인 사례도 공개했다.
내부 테스트에서는 모델 라우팅을 통해 일반 질문 처리 비용을 25% 이상, 코딩 에이전트 비용을 30% 이상 낮췄다. AI 에이전트가 불필요한 검색이나 검증을 반복하지 않도록 업무 수행 경로를 최적화하는 기술도 개발 중이다.
모델 경량화와 추론 속도 개선도 진행하고 있다. 자체 온디바이스 AI 모델 크기를 기존 2.4~3GB에서 약 800MB로 줄였으며, 비교 대상 클라우드 모델 대비 95% 이상의 성능을 확보했다. 작은 모델이 답변을 생성하고 큰 모델이 이를 검증하는 추론 기술(Speculative Decoding) 등을 통해 토큰 생성 속도도 2배 이상 높였다. 관련 연구 논문 2편은 AI 학술대회 뉴립스(NeurIPS)에 채택됐다.
인프라에서는 엔비디아와 AMD의 GPU, 국산 AI 반도체 기업 퓨리오사AI의 신경망처리장치(NPU)를 작업 특성에 따라 조합하는 '칩 믹스(Chip-Mix)' 전략을 추진한다. 연산 성능과 메모리 대역폭 등 반도체별 강점을 활용해 인프라 비용을 낮추겠다는 구상이다.
이 CTO는 "LG유플러스의 토큰 최적화는 이론적 효율화를 넘어 이미 여러 실전 서비스에서 검증한 기술"이라며 "모델 경량화·추론 기술과 AI 업무 수행 과정을 반영한 운영 노하우를 결합해 기업 고객들이 합리적인 비용으로 AI 성과를 낼 수 있도록 시장을 주도하겠다"고 말했다.
- 발로 뛰는 <더팩트>는 24시간 여러분의 제보를 기다립니다.
- · 카카오톡: '더팩트제보' 검색
- · 이메일: jebo@tf.co.kr
- · 뉴스 홈페이지: https://talk.tf.co.kr/bbs/report/write
- · 네이버 메인 더팩트 구독하고 [특종보자→]
- · 그곳이 알고싶냐? [영상보기→]